Claude führt 26 % von Anthropics KI-Forschung – im März 1 %
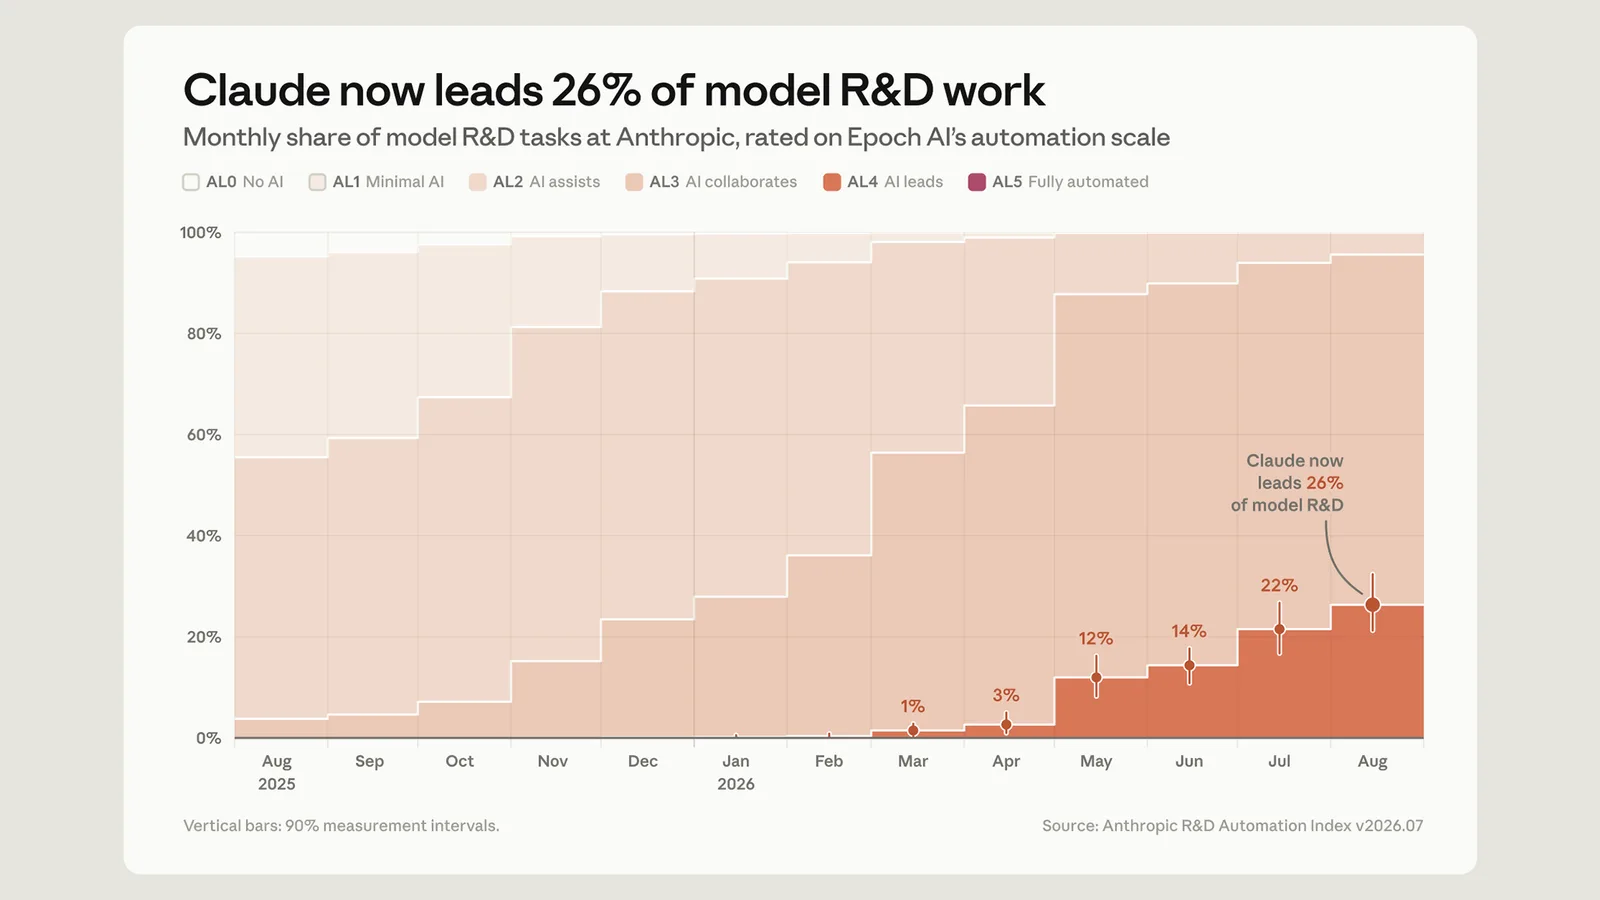
Am 17. September 2026 veröffentlichte Anthropic einen Beitrag mit dem Titel „Measurements for understanding the pace of AI development inside frontier labs“ – und darin eine Zahl, die bislang kein führendes KI-Labor öffentlich genannt hatte: wie viel der eigenen Modellforschung inzwischen vom eigenen Modell erledigt wird. Stand August 2026 „führt“ Claude nach Angaben des Unternehmens 26 % der Modell-Forschung und -Entwicklung – jene Stufe, auf der das Modell nach Anthropics Definition den Großteil einer Aufgabe aus einer übergeordneten Anweisung heraus von Anfang bis Ende erledigt, während ein Mensch beaufsichtigt. Anthropics eigene Grafik beziffert denselben Anteil im März 2026 auf 1 % und im Februar auf unter 1 %.
Die Offenlegung fällt in eine Debatte darüber, wie schnell die Entwicklung an der Spitze voranschreiten sollte, und Anthropic verknüpft beides ausdrücklich: Das Unternehmen schreibt, es erwarte eine Verschiebung dieser Zahlen, falls es zu einer Abstimmung über das Tempo käme, wie sie Firmenchef Dario Amodei gefordert hat. Anthropic schlägt vor, dass jeder Entwickler dieselben drei Kennzahlen veröffentlicht: wie viel KI-Forschung von KI geleistet wird, wie engmaschig die Handlungen von Agenten überwacht werden und wie Rechenleistung verteilt wird.
Die Methode wiegt so schwer wie die Schlagzeilenzahl. Anthropic nennt die Kennziffer Anthropic R&D Automation Index und bewertet Aufgaben auf einer sechsstufigen Automatisierungsskala von Epoch AI, von AL0 (keine KI-Beteiligung) bis AL5 (vollständig autonom, ohne Menschen im Ablauf). Für jede Woche des Juli 2026 wurden 20 % der Beschäftigten aus jeder Abteilung des Modell-F&E-Kreislaufs zufällig ausgewählt; ein Claude-Rechercheagent las Slack-Nachrichten und interne Dokumentation der ausgewählten Personen und listete deren Aufgaben auf – rund 15.000 einzelne Aufgaben. Ein getrenntes Claude-Modell als Gutachter bewertete anschließend jede davon. Dieser Gutachter traf die Einstufung menschlicher Bewerter in 59 % der Fälle exakt – unter Beschäftigten selbst waren es 35 % – und lag in 97 % der Fälle höchstens eine Stufe daneben.
Zwei weitere Messungen zeigen die Größenordnung. Im August 2026 arbeiteten auf Anthropics meistgenutzter interner Plattform zu jedem Zeitpunkt etwa 30.000 Agenten an Forschungs- und Entwicklungsaufgaben. Von mehr als einer Milliarde ausgewerteter Agentenentscheidungen in diesem Monat wurden 0,002 % – etwa 1 von 47.000 – von einem Monitor blockiert; pro Woche werden rund 100.000 Protokolle markiert, etwa 50 davon gehen an einen Menschen. In der Woche vom 13. bis 20. Juli flossen rund 6 % der Rechenleistung für KI-F&E in Sicherheitsarbeit, bei der KI-gesteuerten KI-F&E waren es rund 12 %.
Die Einschränkungen nennt Anthropic selbst. Sämtliche Zahlen sind Eigenangaben und wurden von keiner externen Stelle geprüft; das Unternehmen kündigt an, unabhängige Prüfer mehrerer Organisationen mit einem Zugang vergleichbar zu den internen Risikoteams einzubinden. Zudem ist die Aufgabenliste auf einen Stand von Juli 2026 eingefroren, der Index misst also die Automatisierung jener Arbeit, die Menschen damals verrichteten. AL5 hat Claude in keiner gemessenen F&E-Aufgabe erreicht.
Offenlegung: Der redaktionelle Prozess von NewUJ nutzt die Claude-Modelle von Anthropic.
Quellen
- AnthropicPrimärquelle
- Unite.AISekundär
- BigGo FinanceSekundär
- MixedSekundär
Verwandt
Universal und Sony verklagen Suno erneut: 60.202 Songs
Alibaba gibt CT-KI für 146 Befunde als Open Source frei
Claude beschleunigt 30+ Biomodelle 4x, 1-Mio.-Dollar-Wettbewerb
König Charles mahnt KI-Spitzen: Kontrolle, bevor es zu spät ist
Google Home öffnet sich für Claude und andere KI-Agenten
Huaweis KI-System mit 4.096 Chips ersetzt 48.000 Optikmodule
Anthropic führt Cowork in Claude zusammen, Docs und Slides neu
OpenAI meldet sechs Fälle: Modelle verbargen eigene Fehler
Trending now
- Vier Abonnenten verklagen Anthropic, OpenAI und Google
- Anthropic peilt Börsengang im November mit 2 Billionen an
- NASA zahlt SpaceX 946 Millionen für drei ISS-Crewflüge
- Taifun Dujuan bei Tokio: JR East stoppt Bahnlinien in Chiba
- Haie fressen an Walkadaver auf Jamaika - Behörde warnt
- CVSS 10.0 in Azure AI Foundry: Microsoft schloss die Lücke selbst
- Google: Gemini drang im Mai-Test in drei echte Firmen ein
- Plugin4Shell trifft 4 KI-Coding-Agenten, 2 ohne Patch
Comments
No comments yet. Be the first.